Formation Data Analyst · Fiabiliser, puis analyser
Beaux Logis de Paris
Analyse du marché parisien, prédiction de valeur sous 10 % d'erreur, classification non supervisée.
Contexte et demande
Les Plus Beaux Logis de Paris, société de gestion immobilière fictive, veut estimer la valorisation future de son portefeuille parisien et qualifier automatiquement les biens entrants. Base de travail : 26 180 transactions de 2017 à 2021 pour un modèle prédictif de valeur foncière, puis un clustering K-means pour classer les biens par type.
Démarche
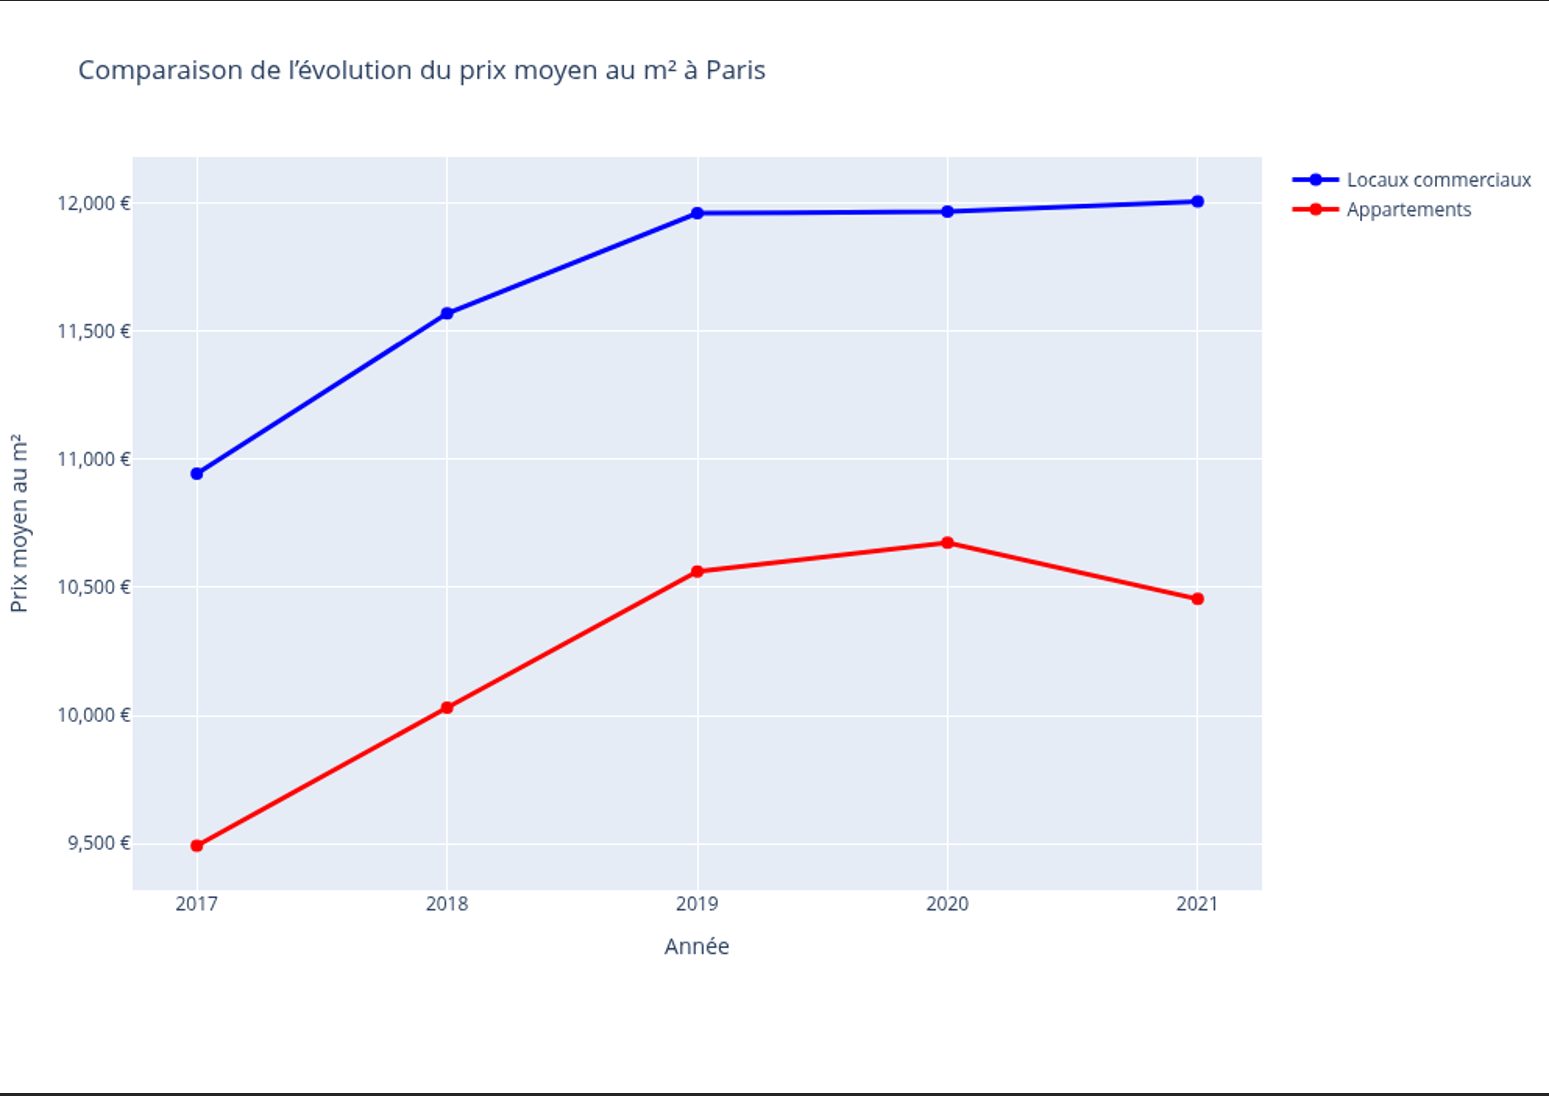
Quatre phases : exploration descriptive du marché, tests de corrélation pour valider les variables, modèle de prédiction de la valorisation, puis K-means pour la classification non supervisée. Parti pris : la transparence sur les limites du modèle.
- Les colonnes du portefeuille ne correspondent pas à celles des données d'entraînement. → correspondance manuelle des variables et colonnes adaptées pour alimenter le modèle.
- La régression linéaire plafonne à 16,71 % d'erreur moyenne, au-dessus des 10 % demandés : la relation n'est pas assez linéaire et les deux types de biens n'évoluent pas de la même façon. → forêt aléatoire entraînée sur un découpage chronologique (2017-2020 pour apprendre, la suite pour tester) : 3,20 % d'erreur, sans surapprentissage marqué.
- Interpréter des clusters sans étiquettes réelles. → étiquettes métier attribuées selon le prix moyen au m² de chaque cluster, avec une formulation prudente.
Livrables
- Notebook Python : audit, analyse du marché parisien 2017-2021, corrélations, régression linéaire puis forêt aléatoire, valorisation du portefeuille, classification de 40 biens
- Support de présentation de 20 pages orienté décision
Résultats
- Forêt aléatoire retenue : 3,20 % d'erreur moyenne sur le test (0,75 % à l'entraînement, R² 0,986 et 0,982), sous le seuil de 10 %
- Portefeuille estimé au 31/12/2022 : 90,48 M€ pour les biens corporate, 66,62 M€ pour les particuliers
- Corrélations de Pearson documentées : date / prix au m² dans le 6e arrondissement (r = 0,90), valeur foncière / surface (r = 0,98)
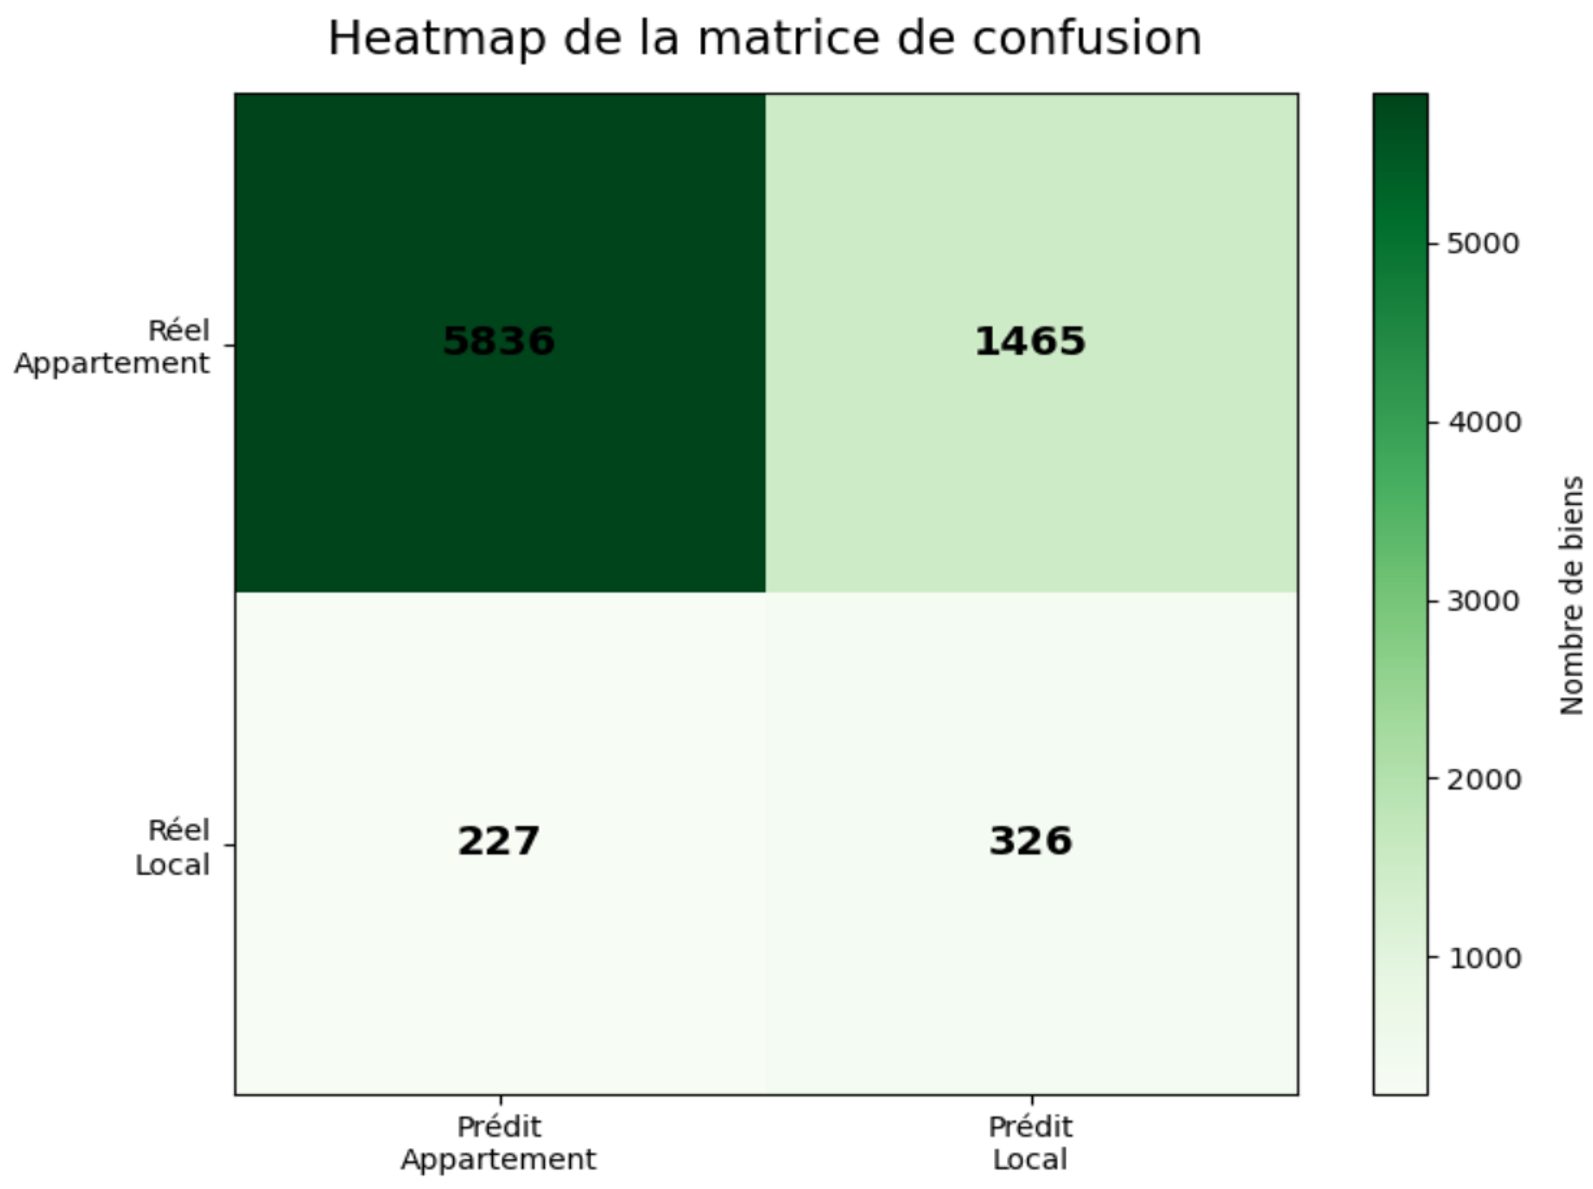
- Classification K-means vérifiée sur l'historique : 78,46 % de bonnes attributions
Ce que j'en retiens
Ce que j'ai aimé
Le projet le plus difficile de la formation à ce stade, donc un vrai défi. Découvrir le machine learning et comprendre la régression linéaire et le K-means assez bien pour les expliquer à un non-technicien : exactement le type d'effort qui fait monter en compétence.
Et si je le refaisais ?
C'est le projet que j'ai réussi mais le plus mal mené. Même si la forêt aléatoire était plus adaptée, une segmentation par quartier aurait pu faire passer la régression linéaire sous les 10 % d'erreur : je ne l'ai faite ni dans l'un ni dans l'autre. Je le reprends dans une version corrigée.
Article à venir : Beaux Logis de Paris, la version corrigéeDétail complet, compétences et livrables à télécharger : page du projet dans l'archive du portfolio v1 ↗
← Retour au catalogue